【教程】ADV解包及机翻汉化教程
❖ 前言
本人是纯文科生,编程基础约等于0,所以汉化出来的游戏都没有太大的难度。
写这篇文章是希望为同样没有编程基础的同好们提供我个人的经验,
很多游戏的汉化流程都大同小异,
希望能为同好们迈出汉化的第一步提供一些方向。
请注意:
不论有多粗略,请务必进行二次校对,至少对术语进行统一,不要折磨你的同好。
回旋镖来了,先用KeywordGacha生成术语表再翻译的话,除了程序问题也没啥需要特意改的了,开摆!
不过翻译前记得检查一遍术语表。
同时注意标注为AI汉化/机翻汉化。
解包、未授权的汉化都是侵权行为。
本文仅供学习交流,如有需要请发邮件至flamecho@qq.com ,在一封邮件内详细描述问题。
在文章下方评论也可以。
如果有过于简略看不懂的地方也可以发邮件或者B站私信,会抽时间做图文教程。
这个教程里没什么图纯是因为懒得搞的,都不知道有无人看
❖ 关于本文
本文以游戏引擎为划分,对游戏汉化中所使用的工具及参考的教程进行列出,请自行下载及查阅。
汉化过程会写的很简略,如有不能理解的地方,请查阅文中提供的教程链接。
由于本文水平有限,当遇到问题或想提升效率时,建议在 御爱同萌 查阅资料。
❖ 工具下载
以下为本文中使用的部分工具:
| 工具 | 引擎 | 用途 |
| GARbro-Mod-1.0.1.2.rar | 通用 | 解包 |
| VNTranslationTools.rar | 通用 | 文本处理 |
| Translator++ | 通用 | 翻译器 |
| AiNiee | 通用 | 翻译器 |
| LunaTranslator | 通用 | 翻译器 |
| Luna翻译模板 | 通用 | 文本处理 |
| SQLiteStudio | 通用 | 数据库编辑器 |
| KeymouseGo | 通用 | 连点器 |
| LinguaGacha | 通用 | 翻译器 |
| KeywordGacha | 通用 | 术语表生成器 |
| SExtractor | 通用 | 文本处理 |
| Transcoding | 通用 | 编码转换 |
| xp3_upk.exe(提取码di6k) | Kirikiri | 解包封包 |
| THE NVL Maker.rar | Kirikiri | 工具包 |
| rpaExtract.exe(提取码af1q) | Ren’Py | 解包 |
| WinAsar.exe(提取码5vt6) | TyranoScript | 解包 |
| dirOpener300-850-1-PC.zip | Macromedia Director | 格式转换 |
| DirectorCastRipper_D10.zip | Macromedia Director | 解包 |
| DirectorCastRipper_D12.zip | Macromedia Director | 解包 |
| Light.vnTools | Light.vn | 解包封包 |
| NS 296 1.04.GBK.exe(提取码1u8f) | NScripter | 汉化启动程序 |
| NSDEC.rar | NScripter | 解包 |
| nsaout.rar | NScripter | 解包 |
| 脚本打包.exe(提取码fhwe) | NScripter | 封包 |
| 资源封装NSA.exe(提取码d5dy) | NScripter | 封包 |
| YPF Manager Tool | YU-RIS | 解包封包 |
| ToolForYuris | YU-RIS | 解包封包 |
❖ LunaTranslator预翻译
这是现在的工作流,建议看这个。下面是一些涉及原理的内容,但有些过时。
思路历程
尝试了一个月,做了四个游戏的汉化,有外挂的(弥赛亚、月蚀狂想、奥兹国),也有内嵌的(断罪玛丽亚,还在玩),算是敲定了我觉得可行的汉化方案。
在将其应用于NS版月影之锁 错乱偏执狂的汉化时,我觉得效果不错,所以在这里记录。
诚然,这是在难以解包封包的情况下的一种不太方便的方案,但优势也很明确:
- 避免了对于版本更迭较频繁的游戏的反复适配,因为不动代码
- 可应用于多平台的游戏,因为通常文本不会有特别大的变化
在汉化 弥赛亚、月蚀狂想 时,我的方案是在游玩过程中,使用翻译器自带的 编辑翻译记录 功能进行校对,并同步丰富术语表。
弊端是这个编辑翻译记录的框挡屏幕,而为了翻译文本能同步到框里,又不得不一直开着它,游玩体验很差。
并且游玩时要等待文本翻译,可能我日语都读完了它还没翻译完,违背我做汉化是为了快点打游戏的初衷。
在汉化 奥兹国、断罪玛利亚 时,我的方案是游戏开自动模式,把整个游戏跑一遍,然后再玩。
解决了需要等待翻译的问题,但弊端也很明显:
术语表不全,且不能联系上下文,翻译质量不太行。
我觉得一定有什么办法能让我在这个方案中使用到AiNiee或LinguaGacha,所以我去LunaTranslator的github翻issue,看到有人问怎么只提取原文,因为他也想放到AiNiee里去翻译。
虽然他没说他想怎么拿AiNiee翻译,但我突然就想通了,于是有了接下来的方案。
提取文本
这里分两种情况,决定了你提取文本的效率:该游戏是否可以内嵌翻译。
内嵌翻译是Hook方法专属,对于不能Hook的游戏,我建议先去LunaTranslator的github提适配请求的issue,如果做不到再考虑OCR。
当你使用OCR方法提取文本时,请参考下文 非内嵌翻译 的部分。
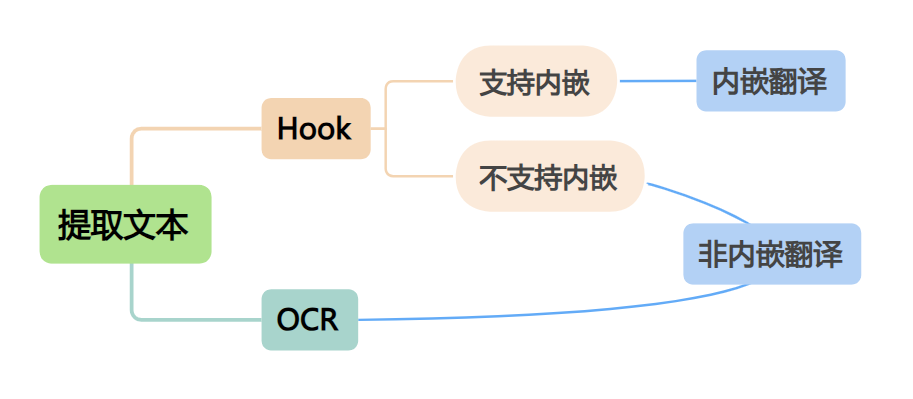
内嵌翻译
你可能会说我不想使用内嵌翻译的功能,因为字体经常有粗有细我不喜欢,大可以放下心来,通过内嵌来提取文本并不会影响你之后不内嵌玩游戏,你只需要提取文本时在 选择文本 中勾选 内嵌 ,而玩游戏的时候勾选 显示 。
关于内嵌翻译,请查看官方文档。
当游戏可以进行内嵌翻译时,意味着即使快进,游戏文本也不会合在一起,而是每句话自成一行。
如果你曾经使用过非内嵌翻译,就会明白我在说什么:非内嵌翻译的情况下,当你快进或者文本点快了,几句话会连在一起并进行翻译,相当抽象。
所以对于可以内嵌翻译的游戏,你需要在 翻译设置 中关闭所有接口,同时打开 自动翻译 (在工具栏上显示为⏩)和 显示原文 (在工具栏上显示为👁️),进游戏点两下确保能且仅能提取到原文文本后,游戏内开启 强制未读快进 或使用全开存档,拿着攻略把整个游戏快进,快速过一遍。
文本全部提取到之后,在 翻译设置 - 其他 - 导出翻译记录为json文件 中,选择 translation_record 中的sqlite文件,在这个文件夹中会生成json文件。
非内嵌翻译
与内嵌翻译的差别是,你需要每句话给翻译器留一两秒的提取文本的时间,不然就会几句话合在一起。
首先仍然是需要在 翻译设置 中关闭所有接口,同时打开 自动翻译 (在工具栏上显示为⏩)和 显示原文 (在工具栏上显示为👁️),进游戏点两下确保能且仅能提取到原文文本。
然后游戏内把文本显示速度和自动模式速度适当调高,可以的话把角色语音都关了以防一句话被语音硬控十几秒,然后开自动模式,把整个游戏过一遍。
不建议使用连点器,点快了文本会连在一起。
文本全部提取到之后,在 翻译设置 - 其他 - 导出翻译记录为json文件 中,选择 translation_record 中的sqlite文件,在这个文件夹中会生成json文件。
补充 快速提取非内嵌游戏文本的方法
文本处理-文本预处理- 开启 过滤换行符;
翻译器-核心设置-HOOK设置-默认设置-刷新延迟,改成0。
同时游戏内快进速度调低一点(适中即可),以防止快进速度过快把两句话连在一起。
然后快进过一遍游戏就行,和上面的 内嵌翻译 是同样的。
但有的游戏快进时hook到的句子稀碎,就用不了这个方法。
如果出现了几句话连在一起的情况,且调低游戏内快进速度也没有改善的话,还是老老实实开自动吧。
连点器
虽然上文中提到不建议使用连点器,但几万句文本中因为连在一起而漏翻个几十句也并非不可接受。
使用KeymouseGo ,我使用的版本是v3.3.2,这里列出我在使用的脚本代码。
主要目的是自动选选项实现挂机打出某个结局,之后再手动回收其他结局。
1 | [ |
1 | [ |
查找并处理连在一起的文本
在SQLiteStudio中,筛选数据-以正则表达式筛选,
输入 (?!^)「 来查找在句中而非句首的 「 ,
输入 (?!^)( 来查找在句中而非句首的 ( ,
输入 (?<!^)(」)(?!$) 来查找在句中而非句首的 」 ,
输入 (?<!^)())(?!$) 来查找在句中而非句首的 ) ,
以此类推,来查找明显是两个句子连在一起了的行。
点击上方工具栏 + 插入新行,编辑文本将一行拆成多行,
注意 source 列和 origin 列都需要编辑。
AI翻译
在文本编辑器(推荐notepad++)中打开json文件。
删除 " 及其前面的空格直至顶格,删除 ": "",
保证每行只有一句原文,不包含其他符号。
新建一个xlsx表格,将所有原文复制到xlsx第一列。
如果粘贴时出现分成两列的情况,参考以下步骤:
- 选中一个带有值的单元格。(即非空的单元格)
- 选择数据> 分列,选择分隔符号。
- 去掉所有分隔符号前面的勾。
- 点击完成。 然后粘贴数据。
在最上面插入一行。
第一行A1填写 Original Text ,B1填写 Initial ,
然后可以使用Ainiee或LinguaGacha翻译,格式选择T++导出文本。
(Ainiee和LinguaGacha具体教程见其他章节)
在使用Ainiee或LinguaGacha翻译之前,可以用KeywordGacha生成术语表以提高翻译质量。
(KeywordGacha具体教程见Kirikiri章节的Collision×Collision)
翻译后得到这样的xlsx文件。
制作补丁
补丁指sqlite翻译记录,将翻译文本导入sqlite文件之后,就可以借助luna翻译器的预翻译功能来游玩游戏。
(luna翻译器的预翻译支持json和sqlite,本教程不使用json的原因是,文本过多时json存在大量文本不显示译文的情况,而sqlite可以规避这一问题。但这似乎与电脑配置有关,暂且画个问号)
打开ainiee或LinguaGacha导出的译文xlsx,把原文那列和第一行都删了,只留译文。
我做了一个模板来调整译文的格式,以便于导入sqlite文件。打开luna翻译模板,把译文复制粘贴到B列,在D列会自动生成符合格式的文本,复制待用。
在 提取文本 那步,我们得到了仅原文的sqlite文件,使用数据库编辑器来打开。
这里我使用的编辑器是SQLiteStudio 。
这个软件在第一次进入时可以选中文,记得选。
左上角 数据库 - 添加数据库 ,选择sqlite文件。
工具 - 打开配置对话框 - 浏览数据 ,将 每页数据行数 设置为10000。(按需设置)
将luna翻译模板中复制待用的D列文本粘贴到 machineTrans 这列。(ctrl+c复制,ctrl+v粘贴)
如果文本行数过多则需要分多次粘贴,上一步设置行数为10000是因为多了电脑会卡。未响应的话等待即可。 粘贴完点击上面有个绿色的✔按钮(提交)。
在 筛选数据 中搜索 {"rengong": ""} ,查找为空的译文,将原文按格式填进去。
会出现这个空行是因为ainiee在原文译文一致的情况下,在译文那列会显示为空。
当你玩内嵌的游戏的时候,如果sqlite中这列文本为空,游戏就会卡住。
如果为空的译文较多,为了提升效率,
你可以将筛选后的 source 列复制到luna翻译模板里再粘贴回 machineTrans 列。
至此sqlite文件的修改就完成了,你可以在luna翻译器中 翻译 - 其他 选择 sqlite预翻译 。
在游玩过程中如有校对需求,可直接在SQLiteStudio中对sqlite文件进行修改,重启luna翻译器后生效。
校对及可能用到的代码
一般直接在 machineTrans 那列直接修改译文即可。
部分文本不显示
注意译文代码与原文保持一致,unity内嵌时此问题尤为高发。
" 需要替换为 \" ,否则含有 " 的句子都会漏翻。
批量替换工具 - 打开SQL编辑器
1 | UPDATE artificialtrans |
执行语句 。查找多行连在一起的情况
正则表达式查找
1 | (?!^)「 |
1 | (?!^)( |
1 | (?<!^)(」)(?!$) |
1 | (?<!^)())(?!$) |
1 | ^(?=(.*?【){3}).+$ |
原文删除人名
删除hook模式可能提取到的人名,建议将原文复制到notepad++等文本编辑器后处理文本。
正则表达式查找,替换为 「
1 | 【[^】]*】「 |
1 | ^[^\n「]*「 |
找翻译有误的译文
1 | [a-zA-Z] |
1 | [嘅咗咁哋睇嚟噉嘢攰冧叻嬲氹捩瞓] |
1 | ...... |
1 | -> |
1 | 俺 |
在 」后换行
正则表达式替换,将
1 | 」(?!\r?\n) |
替换为
1 | 」\r\n |
❖ Kirikiri
简称 krkr 。
包括 krkr krkr2 krkrz 这三个版本,汉化方式一致,特征为文件后缀为 xp3 。
大秽前篇(使用VNTranslationTools和AiNiee)
引擎为 krkrz 。
解包
使用 xp3_upk ,将 data.xp3 拖到 xp3_upk.exe 上,在同目录出现名为 data 的文件夹即为游戏文件。
xp3_upk.exe(提取码di6k)
提取文本
大秽的文本在 data\scenario 。
使用 Translator++ 会出现汉化文本导入不全的问题,因此使用 VNTranslationTools 。
VNTranslationTools.rar
使用方式参考B站@五娼会会长:Krkrz游戏汉化全流程中的第五步,提取出 json 格式的文本。
汉化
使用 AiNiee 对文本进行AI翻译。
AiNiee:一款专注于Ai翻译的工具
翻译设置选择 VNText导出文件 ,使用方式参考B站@TJJtjj:用AiNiee+ChatGPT翻译renpy游戏中的AiNiee设置部分。
翻译完用 VNTranslationTools 将 json 格式的翻译文本改为 ks 格式的剧本文件。
制作补丁
如有署名需求,游戏标题的修改位置: data\system\Config.tjs;System.title = "游戏标题";
有两种汉化发布方式。
- 新建一个名为
patch的文件夹,将所有修改后的文件放进去(文件夹中不要有其他文件夹,所有文件都是直接放在patch文件夹内),将patch文件夹拖到xp3_upk.exe上,同目录生成patch.xp3。
分发patch.xp3即可。 - 如要将汉化补丁封包入exe中,使用
Enigma Virtual Box。
Enigma Virtual Box官网:下载Enigma文件打包工具
上方language修改软件语言为中文,选择待封包的主程和封包程序另存后,点一下下方Virtual Box Files的字样,将patch文件夹拖到下方一片空白的地方,选%DEFAULT FOLDER%,最后选执行封包。
分发修改后的exe即可。
Cocoon(使用Translator++和Ainiee)
引擎为 Krkr 。
解包
资源文件被封装进了 exe 中,无法使用 xp3_upk 解包,因此使用 GARbro 对 exe 进行解包。
使用方法请看本文 YU-RIS 章节的 未成之缘 なりそこないのよすが 的解包部分。
解密方法选 海と雪のシアンブルー 。
汉化1
使用 Translator++ 和 Ainiee 进行文本提取和翻译。
流程可以参考B站@TJJtjj:用AiNiee+ChatGPT翻译renpy游戏,最开始选 Kirikiri Adventure Game 。
做到把翻译好的游戏文件导出到文件夹那一步就可以了。
汉化2
但这种方式有个问题: 人名 并没有被提取出来。
所以在将翻译好的游戏文件导出到文件夹之后,要对游戏文本中的人名部分进行进一步的修改。
使用 notepad++ 来进行同一文件夹内所有文本的批量替换。
CSDN@° 安如少年初如梦662:最新版Notepad++ 下载与安装教程
百度经验@书香驿站:用Notepad++批量修改替换多个文件内容
krkr的人名表示方法:[名前 n="名字"]
制作补丁
这个游戏已经发布了两个补丁 patch1.xp3 patch2.xp3 ,
而krkr的补丁读取顺序是 如果多个补丁中存在相同名字的文件,则优先读取数字更大的补丁中的该文件 。
因此与大秽略不同的、该游戏补丁的制作方式为:
新建一个名为 patch3 的文件夹,将所有修改后的文件放进去(文件夹中不要有其他文件夹,所有文件都是直接放在 patch3 文件夹内),将 patch3 文件夹拖到 xp3_upk.exe 上,同目录生成 patch3.xp3 。
分发 patch3.xp3 即可。
xp3_upk.exe(提取码di6k)
Cocoon -Black Noise-(使用Translator++和Ainiee)
引擎为 Krkr 。
解包
使用 xp3_upk ,将 data.xp3 拖到 xp3_upk.exe 上,在同目录出现名为 data 的文件夹即为游戏文件。
xp3_upk.exe(提取码di6k)
汉化
使用 Translator++ 和 Ainiee 进行文本提取和翻译。
流程可以参考B站@TJJtjj:用AiNiee+ChatGPT翻译renpy游戏,最开始选 Kirikiri Adventure Game 。
做到把翻译好的游戏文件导出到文件夹那一步就可以了。
制作补丁
如有修改游戏标题的需求,需修改 data\system\Config.tjs 第17行 System.title 。
此文件如果打开来是乱码,请使用 notepad++ 或任意编辑器修改编码为 UTF-16LE 。
如果修改后游戏报错,则在修改标题时 不要使用简体中文 。
新建一个名为 patch 的文件夹,将所有修改后的文件放进去(文件夹中不要有其他文件夹,所有文件都是直接放在 patch 文件夹内),将 patch 文件夹拖到 xp3_upk.exe 上,同目录生成 patch.xp3 。
分发 patch.xp3 即可。
Collision×Collision(使用Translator++和LinguaGacha和KeywordGacha)
翻译大秽完全版时也是这个方案,但是当时没记录,所以换个游戏来过一遍翻译流程。
使用KeywordGacha生成术语表
- 打开 Translator++ ,创建新工程。
选择Kirikiri, Game executable 选择游戏exe,然后点击Create Project。
发现正常没提取到文本,所以把Extract XP3 files和Decrypt encrypted files的选项打开,再点击一次Create Project,这次没问题。 - 根据KeywordGacha的推荐方式,导出游戏文本为
xlsx格式。步骤如下:
Collision×Collision的文本只有一个 first.ks ,所以打上 first.ks 前面的✔,右键-With1已选择-导出到-Excel2007电子表格,
Read Character encoding 填shift-jis, utf-16, utf-16le, utf-8,
Write Character encoding 选UTF-16LE,导出文件。 - 把要翻译的文件之外的文件都删了。
删除方式为在上一步右键时有个删除文件的选项。
(如果接下来你使用 LinguaGacha 翻译时想要翻译xlsx文件而不是 trans 文件,则不用删。我个人建议翻译 trans 文件, xlsx 文件翻译串行的概率不低。)ctrl+s保存 trans 文件,关闭 Translator++ 。 - 修改 KeywordGacha 文件夹下的
config.json,配置api_keybase_urlmodel_name。
我使用的是 deepseek-v3 ,
获取apikey可查看这个教程,
base_url 为https://ark.cn-beijing.volces.com/api/v3,
model_name 为deepseek-v3-250324。 - 将 Translator++ 导出的
xlsx文件放入 KeywordGacha 文件夹下的input文件夹内。
双击app.exe启动工具,输入5来测试接口是否配置正确。
显示接口测试执行成功,按回车,输入3(如果你是其他语言则视情况而定),再按回车,等待分析结束。
分析结束后按回车关闭KeywordGacha。 - 在 KeywordGacha 文件夹下的
output文件夹中,对照日志校对json或xlsx文件,两种格式的术语表校对哪个都可以。
个人觉得汉字的人名标个性别就可以,需要多加注意的是读音的片假名要在术语表中确定汉字怎么写,不然就会乱翻译。
使用LinguaGacha翻译文本
- 参考这个教程进行软件的基础配置。
- 开始翻译-开始,等待翻译结束。
- 使用 Translator++ 打开
output文件夹中翻译过的trans文件。
(如果你翻译的是xlsx文件,可以查阅上面其他游戏的教程)
你可以在 Translator++ 中直接进行校对工作,但由于相同句子可能有不同的翻译(比如はい),而 Translator++ 的差分翻译实际上并不方便,我会导出为ks文件后,用notepad++直接修改 ks 文件。
一般我也会同时开着 Translator++ 方便我在校对时去翻原文。
导出ks文件的方法:打上 first.ks 前面的✔,右键-With1已选择-导出到-文件夹。 - (可选)翻译错误到了需要重新翻译部分句子的程度的时候,LinguaGacha的
百宝箱里有批量修正和部分重翻的功能,软件内有引导。 - 封包,制作补丁等看上面其他游戏的教程。
オルフレール(处理*.snr,使用SExtractor提取和导入文本)
参考了 这个帖子 的教程。
snr格式的文本不能用Translator++或VNText提取文本并翻译,所以需要用到 SExtractor 。
本章节会简化某些步骤,如有不能理解的地方请查看上面的游戏流程。
准备工作
在Github下载SExtractor,点击右上角绿色的 Code 图标,选择 Download ZIP 下载到本地。
在Github下载Transcoding,用于文件编码的批量转换。
如果你没有安装过python,那么在python官网 下载3.11及以上版本并安装。
新建一个叫 SE提取注入 或任意你喜欢的名字的文件夹,用于之后放需要翻译的文件。
解压SExtractor的压缩包,双击 安装依赖.bat ,然后双击 运行.bat 启动软件。
解包
将 data.xp3 拖到 xp3_upk.exe 上解包。
剧本文件在 data\snr ,游戏名设置在 data\settings\System.ini ,默认主角名在 data\settings\Other.ini 。
汉化
使用notepad++或任意常用文本编辑器打开 data\snr 下的snr文件,以 shift-jis 编码查看哪些是需要翻译的文件,将需要翻译的snr文件都放到 SE提取注入 文件夹内。
启动SExtractor,如下设置:
引擎为 Krkr_Reg ,导出格式为 json[{name,msgRN}] ,导出方式为 多文档 ,匹配规则为 _Custom0 ,TXT编码为 cp932、UTF-8 (即导入原文编码cp932,导出译文编码UTF-8)。
1 | 00_skip=^.*[;/].*$ |
点击 提取/写入 ,在 SE提取注入 下生成几个文件夹。
使用Ainiee等翻译软件对 orig 文件夹下所有json文件进行翻译(不要对json文件做任何修改),翻译后的json放入 trans 文件夹。
再次点击点击 提取/写入 ,在 new 文件夹下生成翻译后的snr文件。
使用 Transcoding 将所有修改的可用notepad++打开的文件(包括但不限于*.snr、*.ini)的编码修改为 UTF-16LE 。
如果显示文件格式不支持,你可以使用如下的代码写一个批处理文件来更改文件后缀。
(如何写一个批处理文件:新建一个txt,把代码复制进去,把txt后缀改为bat,双击bat,等待,按回车关闭弹窗)
1 | @echo off |
将文件编码修改为UTF-16LE后,再把文件后缀修改回snr。
1 | @echo off |
ini 后缀的文件用notepad++手动修改编码为UTF-16LE。制作补丁
新建名为 additional 的文件夹,将所有修改过的文件放进去,把文件夹拖到 xp3_upk.exe 上封包。
分发 additional.xp3 即可。
问题解决方案
文件有加密,解压文本乱码
比如文件夹里有 data.xp3.sig ,用xp3upk、garbro解包都乱码时,
可以用Translator++来解包。
新建工程-Kirikiri Adventure Game,如图所示。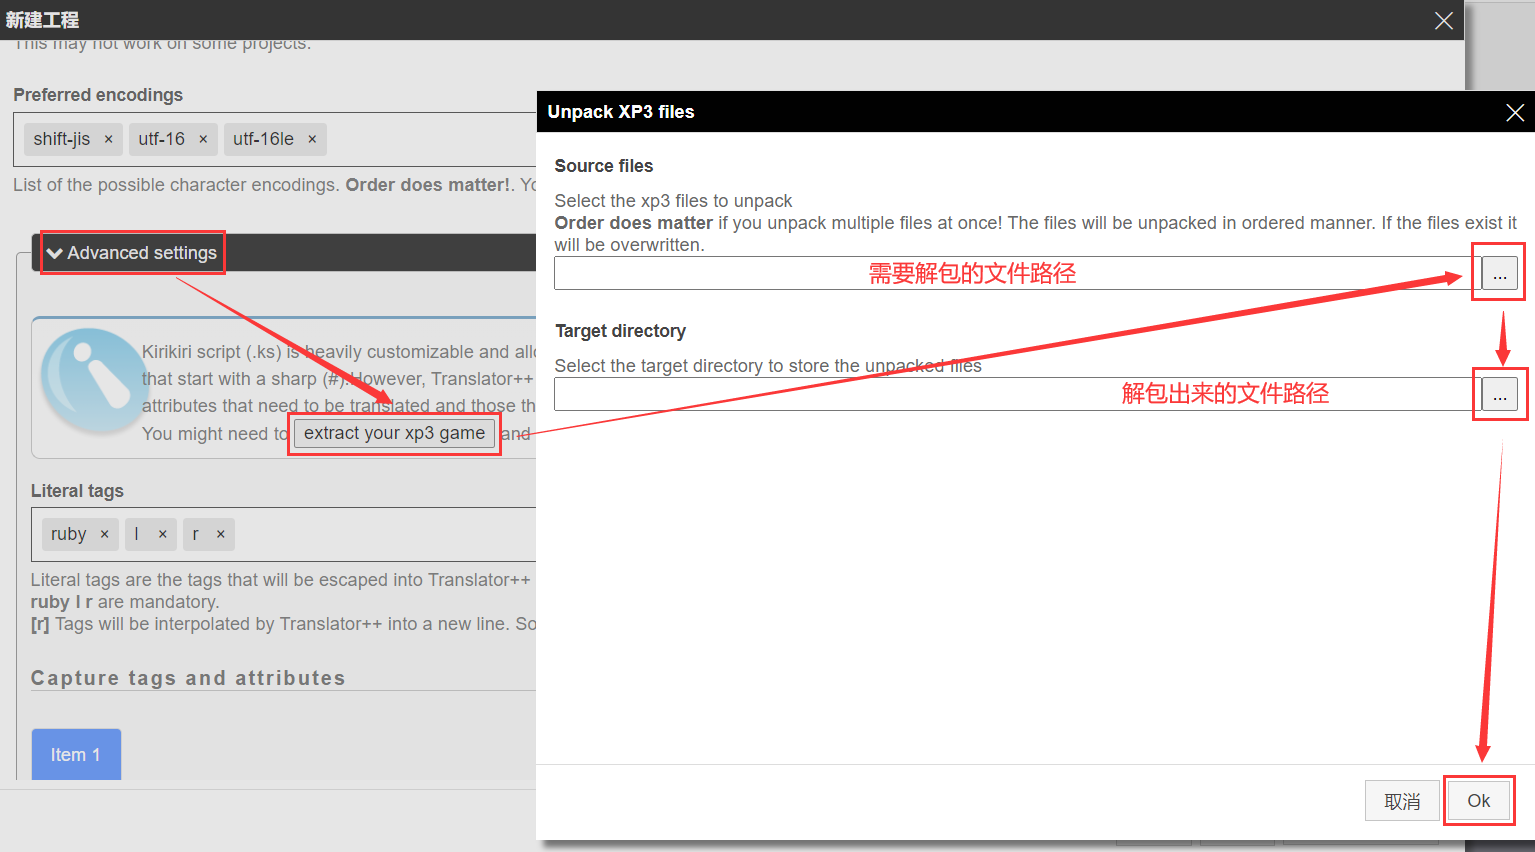
导入T++后,汉化文本里有\
删了就行,不会报错。
导入T++后,汉化文本里有\n
全文替换为 [r] 。
从T++导出后游戏文本乱码或缺字
Reading Character encoding填 shift-jis, utf-16, utf-16le, utf-8
Write Character encoding选 UTF-16LE
ruby text在报错
中间空格没了,把rubytext替换为 ruby text 。
更换字体
有以下三种方法:
- 替换config.tjs里的
userFace,须为电脑上已安装的字体。
若游戏已引入外部字体,则替换mappfont storage。
将字体安装文件随汉化补丁分发,以防其他玩家电脑上未安装该字体。
若修改为引擎自带的宋体、新宋体、黑体、楷体_GB2312、仿宋_GB2312,则不需要分发字体安装文件。 - 使用THE NVL Maker里的
krkrfont,将想引入的外部字体的字体文件转换为tft文件。
在ks文件开头设置[deffont face="字体名"]。
将tft文件放入patch.xp3,删除存档后进游戏看效果。
因在日文版krkr中,若借助LE转日区打开游戏,则中文字体会有粗有细,
为规避这一问题,需将所有可用记事本打开的文件编码都转换为UTF-16LE。
UTF-8应当也可行但我没试过,须保证所有文件的编码一致,否则会报错。
你可以使用notepad++完成转编码的操作。
THE NVL Maker.rar - 在config.tjs中调整菜单为显示状态,在菜单里调字体。
1
2
3// ◆ メニューバーを表示するか
// 非表示にすると当然どのメニュー項目にもアクセスできなくなります。
;menu.visible = true;
❖ Ren'Py
特征为文件后缀为 rpa rpy 。
这个引擎的游戏的UI基本都是可修改的文字,大大减少了修图的工作量。
注意代码和只有全小写的单词的行不要翻译,会报错。
Dreambound(使用Translator++和Ainiee)
解包
资源文件在 game\archive.rpa
使用 rpaExtract ,将archive.rpa和rpaExtract.exe放在较短的全英文路径的同一文件夹中,将archive.rpa拖到 rpaExtract.exe上等待即可。
rpaExtract.exe(提取码af1q)
汉化
使用Translator++和Ainiee进行文本提取和翻译。
流程可以完全参考B站@TJJtjj:用AiNiee+ChatGPT翻译renpy游戏。
需调整的文件位置game\chapters #剧本文件game\script.rpy #人名game\chapter_screen.rpy #章节名game\gui.rpy #字体 建议直接把你想使用的字体的文件名改为游戏使用的字体的文件名,覆盖掉原字体
根据汉化Beyond Eden时的经验,
ui的文字在 renpy\common\00layout.rpy 修改,双引号内的是可修改的文字。
制作补丁
保持目录结构一致,直接覆盖游戏原文件。
将修改后的后缀为 rpy 的文件,放在 archive.rpa 同一文件夹中。
❖ TyranoScript
这个引擎做的游戏的默认图标是个恐龙玩偶外套的女孩(男孩?)。
存档后缀是 .sav ,通常游戏资源全都封装在了exe里导致exe特别大。
解包方式也很粗暴,把exe后缀改为zip,解压就可以了。
但总有意外之时,比如PSYCHIC ECLIPSE
解压之后会有个叫 tyrano 的文件夹。
powdergray(使用Translator++和Ainiee)
解包
exe后缀改为zip,用winrar(或任意能解压zip的软件)解压。
汉化
使用Translator++和Ainiee进行文本提取和翻译。
流程可以参考B站@TJJtjj:用AiNiee+ChatGPT翻译renpy游戏,最开始选 TyranoScript Game 。
做到把翻译好的游戏文件导出到文件夹那一步就可以了。
制作补丁
使用Translator++导出游戏文件的话,正常来说是会按正确的目录结构来导出的。
你也可以把exe解包了看看他里面的目录结构是什么样的,把文件按结构放好。
然后查看 data\system\Config.tjs 中的 projectID 。
将游戏文件压缩为zip,压缩时命名为 projectID.zip ,压缩后重命名为 projectID.tpatch 。(这里都是之前查到的projectID)
分发这个tpatch即可,使用方法为放在exe同路径下。
TyranoScript的tpatch原理是,在打完补丁后初次打开游戏时会解压tpatch内的文件覆盖到exe中的游戏文件上,所以要保持与exe中目录结构一致。
PSYCHIC ECLIPSE -心灵侵蚀-(使用Translator++和Ainiee)
解包
资源文件在 resources\app.asar
使用 WinAsar ,左侧点 Extract ,右上角点 Open 选择要解包的 app.asar ,
下方选 Extract ,等待读条结束。
在app.asar同文件夹会出现名为 app.asar.unpack 的文件夹,里面即为游戏文件。
WinAsar.exe(提取码5vt6)
汉化
使用Translator++和Ainiee进行文本提取和翻译。
流程可以参考B站@TJJtjj:用AiNiee+ChatGPT翻译renpy游戏,最开始选 TyranoScript Game 。
做到把翻译好的游戏文件导出到文件夹那一步就可以了。
制作补丁
在查阅下方文字前,请先把下方提供的汉化补丁下载并解压(tpatch后缀改为zip后解压),以便于理解这个汉化补丁的结构以及各个文件都是怎么来的。
【杂谈】汉化发布页
我上网查了很久也没找到这个游戏补丁应该是什么结构,硬试出来的
如果汉化后发现角色都哑巴了,记得所有剧本文件中的 vrepeat name 也需要修改为中文人名。
data\image\button #选项,这游戏的选项都是图片,需要ps汉化data\others #引入的外部字体data\scenario #Translator++导出的汉化剧本文件data\scenario\first.ks #第5行 title name可修改游戏标题data\system\Config.tjs #第72行 userFace修改为引入的外部字体名;记录下第6行projectIDtyrano\css\font.css #第16-25行 引入外部字体样式
将data和tyrano两个文件一起压缩为zip,压缩时命名为 projectID.zip ,
压缩后重命名为 projectID.tpatch 。(这里都是之前查到的projectID)
分发这个tpatch即可,使用方法为放在exe同路径下。
❖ YU-RIS
Translator++支持汉化的YU-RIS版本有限。
未成之缘 なりそこないのよすが(使用Translator++和Ainiee)
解包
使用GARbro,资源文件在 pac 文件夹中,选 尝试猜测 即可。
使用教程:B站@风于落叶:GARbro使用教程及诸多解包/打包工具包。
GARbro-Mod-1.0.1.2.rar
汉化
使用Translator++和Ainiee进行文本提取和翻译。
流程可以参考B站@TJJtjj:用AiNiee+ChatGPT翻译renpy游戏,最开始选 YU-RIS engine translator 。这个插件需要在Translator++的 选项-插件 中安装。
这种汉化方式可以避免编程,坏处是无法给文本换行,但能汉化已经算是赢。
这一步做到文本汉化结束为止,不需要导出游戏文件到文件夹中。
制作补丁
给所有疑似人名而非对话的行都Tag为红色。
点击Translator++上方 Inject/apply all translation 。请选择需要应用的列 选择游戏原版的文件夹。将会在该位置生成注入翻译之后的游戏的副本 选择汉化补丁想要放在的位置。(建个空文件夹)复制原文件 选择 Do not copy materials, inject translation only 。标记 点亮红色,选择 Do not process row with selected tag (black list) 。Bulid option 选择 Repack into origin YPF file(s) 。
点击 应用翻译 。
在之前选择的汉化补丁想要放在的位置会生成一些文件,这些即为汉化补丁,分发即可。
一些工具
有些游戏在使用Translator++汉化时会出现补丁不生效、卡住等问题,
我查看了一些教程,虽然最后还是没成功,但我认为可以记录一些有用的工具,也许在其他游戏用得上。
有用的教程
我很幸运地遇到了 免封包处理 中的 一些意外 ,所以卡在这一步放弃了。
有用的工具
都是用于解包封包的命令行工具。
使用方式为解压压缩包后, win+r 输入 cmd 打开命令行,输入 cd 压缩包内exe所在的文件夹路径 ,然后输入 ToolForYuris.exe 或 YPFManager.exe ,之后输入对应操作的指令。
你可以将输入exe后出现的说明复制发给deepseek,说明你的需求,让deepseek告诉你应该输入什么指令。
❖ Macromedia Director
只有解包教程。
好きなものは好きだからしょうがない!! FIRST LIMIT
解包
使用 DirectorCastRipper ,使用教程见该项目的Github说明。
CG、BGM、剧本都在 DATA\CAST 下,把想解包的 cxt 文件拖到DirectorCastRipper上即可。
DirectorCastRipper_D10.zip
DirectorCastRipper_D12.zip
思考汉化方式时找到的工具
虽然最后没用上,因为文本换行问题,机翻有点耗时,就放弃了。
但是想到了别的汉化方式,所以也不算完全无功。
dirOpener,这是一个将受保护的 cxt 等文件转换为可使用Macromedia Director编辑的 cst 等文件的软件。
在使用时需要将想转换的文件和dirOpener放在同一目录下,将想转换的文件拖到dirOpener上即可。
dirOpener300-850-1-PC.zip
❖ NScripter
CAGE-CLOSE-(使用Excel和Ainiee)
机翻完了没空校对,来记录一下过程。
解包
使用GARbro,资源文件在 arc.nsa 中。
使用教程:B站@风于落叶:GARbro使用教程及诸多解包/打包工具包。
GARbro-Mod-1.0.1.2.rar
汉化1
文本在 nscript.dat 。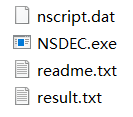 将nscript.dat和NSDEC.exe放在同一文件夹内,将nscript.dat拖到NSDEC.exe上,生成
result.txt 。
NSDEC.rar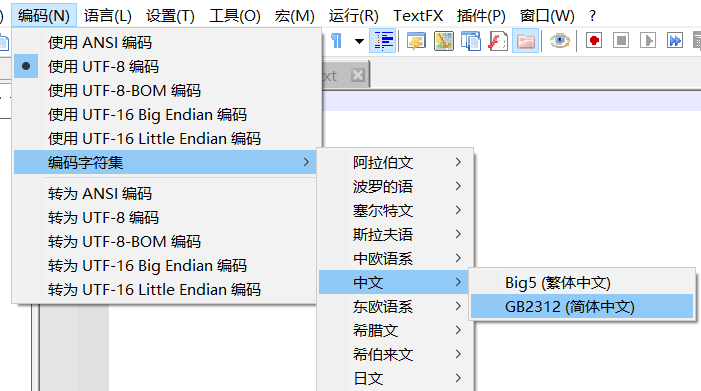 在notepad++新建一个txt,编码改为
GB2312 ,将result.txt内的所有内容复制到新建的txt里,将新建的txt保存并命名为0.txt。
汉化2
2025.9.13更新:
以下的翻译步骤建议参考本文 Kirikiri 章节的 オルフレール 章节,使用SExtractor对原文进行处理以减少需要翻译的内容,从而减少token使用、提升翻译质量和降低报错几率。
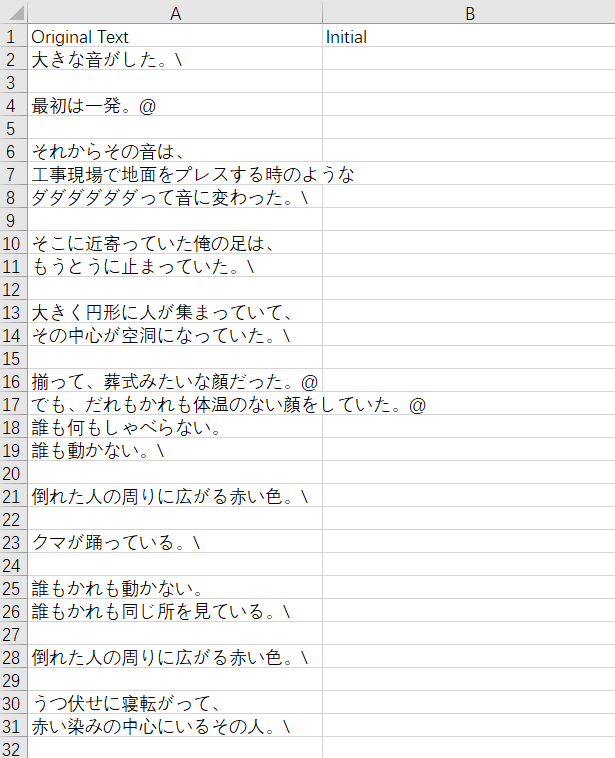 新建一个
xlsx 表格,将所有原文复制到xlsx第一列。
如果粘贴时出现分成两列的情况,参考以下步骤:
- 选中一个带有值的单元格。(即非空的单元格)
- 选择数据> 分列,选择分隔符号。
- 去掉所有分隔符号前面的勾。
- 点击完成。 然后粘贴数据。
第一行A1填写 Original Text ,B1填写 Initial ,然后使用Ainiee翻译,格式选择T++导出文本,记得勾选代码救星插件。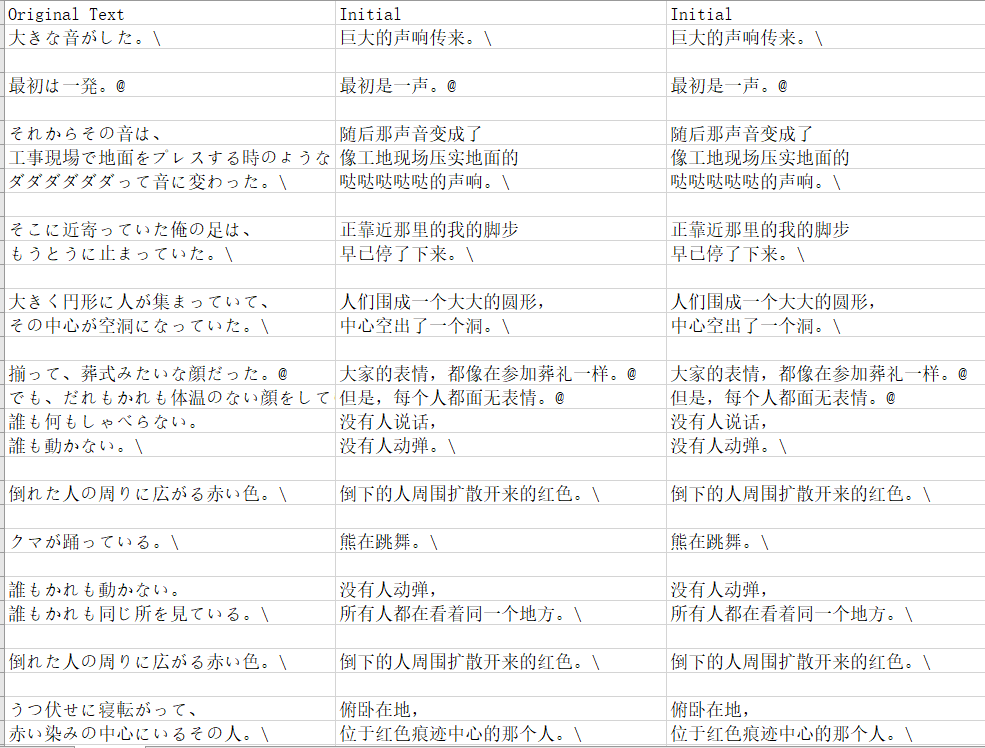 第一列是原文,第二列是Ainiee翻译的文本,为了合并两列的代码和汉化文本,在
C1 填写 =IF(AND(A1="", B1=""), "", IF(B1="", A1, B1)) 然后下拉填充到最后一行,将C列的所有文本(第一行除外)复制粘贴到0.txt的对应部分,实现文本汉化。
1 | =IF(AND(A1="", B1=""), "", IF(B1="", A1, B1)) |
注意把汉化文本中所有的半角字符、数字都改为 全角字符 ,否则会报错。
如果从excel复制到txt多了双引号的话,就先复制到word,再从word复制到txt。
制作补丁
有两种制作补丁的方式:
- 分发
0.txt和NS 296 1.04.GBK.exe:
0.txt可以直接放在游戏文件夹内,但需要删除原本的nscript.dat,然后使用NS 296 1.04.GBK.exe启动游戏。这个exe可以重命名。 - 分发
汉化版nscript.dat和NS 296 1.04.GBK.exe:
能让玩家直接替换总比让玩家自己删文件要容易很多。使用脚本打包.exe将0.txt转换为nscript.dat,软件内有引导。
NS 296 1.04.GBK.exe(提取码1u8f)
脚本打包.exe(提取码fhwe)
备注
我不打算进行图片的汉化,但还是有必要说明一下如何进行这一步。
使用 nsaout 进行 arc.nsa 的提取,将 arc.nsa 和 nsaout.exe 放在同一文件夹内,将 arc.nsa 拖到 nsaout.exe 上,生成 arc 文件夹。
nsaout.rar
修改图片后,用 资源封装NSA.exe 将 arc文件夹封装为arc.nsa。
资源封装NSA.exe(提取码:d5dy)
海色狂詩曲 -ウミイロラプソディ-(问题解决方案)
过程跟上面是一样的,记录一些问题的解决方案:
文字全乱码
确保0.txt的编码为 GB2312 。
个别文字乱码
包括但不限于:
- 文本中的ABCD等字母需要为全角符号。
- 句子里可能有个逗号是英文的半角逗号,改为中文的全角逗号。
无法存档
这个问题我没解决,如果有人知道希望可以告诉我,虽然我觉得影响也不大,大不了一次性通关。
我发现日文版也无法存档,所以不是汉化导致的问题。
而这个游戏总不至于发布出来就是存不了档的,以兼容性打开也没用,所以我倾向于认为是windows版本太高导致的。
文本框的位置有问题
使用Translator++进行汉化的话有时候会把第一行吞了,或者为了省ai的token没有把txt最上和最下的大段代码也复制到excel里,结果从excel粘贴回txt的时候忘记把最上和最下的代码也粘贴回去。可能听起来很荒谬,但我真的出过这种错
注意代码是否完全还原。
刚进游戏就报错
这基本可以确定是代码出错了。
有两种可能:
- ainiee把代码也翻译了。
如果你已经翻译完了,要么批量替换,要么把代码救星插件开了重新翻译一遍。 - 从excel粘贴到txt的时候多出来一堆双引号。
这似乎是excel的分隔符之类的问题,解决方案是先从excel复制到word,再从word复制到txt。
选择肢报错
把选项里面的\删了。
文字超出窗口
在确保以上问题都不存在的情况下再来看这条。
在nscript的语法中,\是换页。
所以你需要在没换行的句子结尾加一个\,来让它成功地换到下一页去,就不会超出窗口了。
❖ Light.vn
Lost Friends3 -Never returN-(使用Excel和Ainiee)
解包
资源文件在Data文件夹下的一堆 vndat 文件里。
使用Light.vnTools,将vndat文件拖到LightvnTools.exe上,在游戏文件夹同路径出现解包文件夹。
记得事先安装.NET 7.0 SDK或.NET 8.0 SDK,不同版本的SDK需要使用对应版本的Light.vnTools。
Light.vnTools-v1.2.0-net7.zip
Light.vnTools-v1.2.0-net8.zip
data001 #BGMdata002 #字体data003 #图片data004 #视频data005 #剧本data006 #音效
汉化
2025.9.13更新:
以下的翻译步骤建议参考本文 Kirikiri 章节的 オルフレール 章节,使用SExtractor对原文进行处理以减少需要翻译的内容,从而减少token使用、提升翻译质量和降低报错几率。
- 用notepad++打开data005.vndat里的txt,修改为UTF-8编码 不然就会乱码 。
- 对文本进行汉化,机翻汉化的流程可参考NScripter章节的CAGE-CLOSE-。
大致流程是新建一个xlsx表格,将所有文本粘贴到第一列,第一行A1填写Original Text,B1填写Initial。 - 使用Ainiee翻译,格式选择T++导出文本。
- 参考CAGE-CLOSE-教程导入文本的那一步,文本导入完成就结束了。
制作补丁
有两种制作补丁的方式:
- 把包含修改过的文件 注意这里只能是Data文件夹内的修改过的文件,如果要修改Config文件夹内的文件,则要直接覆盖,而不是压缩在补丁里,详见下方提供的补丁 的data005文件夹和data005.vndat放在同一目录下,把data005文件夹拖到LightvnTools.exe上,分发新生成的data005.vndat。
【杂谈】汉化发布页 - 把任意一个vndat文件重命名为
Patch.vndat,把修改过的文件按照目录结构放在一个名为Patch的文件夹内,将Patch.vndat和Patch文件夹放在同一目录下,把Patch文件夹拖到LightvnTools.exe上,分发新生成的Patch.vndat。
这里的目录结构意思是,比方说data005.vndat的文件结构是data005\Scripts\xx.txt,那么Patch文件夹则是Patch\Scripts\xx.txt。
❖ AIRNovel
一个基于Adobe Air的游戏引擎,因此要游玩这个引擎制作的游戏需要先安装Adobe Air。
Re;quartz(使用Excel和Ainiee)
解包
不知道是这引擎不能封包,还是这游戏就是没封包,总之所有资源都在明面上,不需要拆。
汉化
2025.9.13更新:
以下的翻译步骤建议参考本文 Kirikiri 章节的 オルフレール 章节,使用SExtractor对原文进行处理以减少需要翻译的内容,从而减少token使用、提升翻译质量和降低报错几率。
- 用notepad++打开scenario文件夹里的
an后缀的文本。 - 因为我想使用ainiee的代码救星插件,所以将文本粘贴到excel中伪装成T++导出文本。具体参考本文NScripter章节中的汉化部分。
- 机翻完把excel中的文本粘贴回an后缀的文件,然后放回scenario文件夹。
- 修改图片方面直接去对应文件夹找图片P图。
制作补丁
把修改过的文件直接分发出去,替换即可。
❖ System-NNN
cyc社常用的游戏引擎。
薔薇ノ木ニ薔薇ノ花咲ク(使用VNTranslationTools和Ainiee)
解包
使用GARbro,各个文件夹中, spt 是文本, dwq 是图片, vaw 是音乐。
使用教程:B站@风于落叶:GARbro使用教程及诸多解包/打包工具包。
GARbro-Mod-1.0.1.2.rar
提取文本
使用VNTranslationTools。
VNTranslationTools.rar
使用方式参考B站@五娼会会长:Krkrz游戏汉化全流程中的第五步,提取出json格式的文本。
汉化1
使用AiNiee对文本进行AI翻译。
AiNiee:一款专注于Ai翻译的工具
翻译设置选择 VNText导出文件 ,使用方式参考B站@TJJtjj:用AiNiee+ChatGPT翻译renpy游戏中的AiNiee设置部分。
翻译完用VNTranslationTools将json格式的翻译文本改为 spt 格式的剧本文件。
汉化2
导入游戏后会发现汉字不能正常显示,需要打上VNTranslationTools提供的字体补丁。
将导出spt文件时一同生成的 sjis_ext.bin 放在与游戏exe同目录下。
然后打开VNTranslationTools文件夹,将 VNTextProxy 文件夹中的dll依次放入游戏exe同目录下,测试哪个dll能使文本正常显示。
汉化3
文本正常显示后发现对话框里的文本会出现在人名框中。
发现这个问题仅出现在旁白,即json文件中没有name一行的文本中。
使用notepad++进行批量替换,在这种行上添加 "name": " " 注意双引号里有个空格,让不存在人名的旁白行也能给人名框留出一行位置,如下图。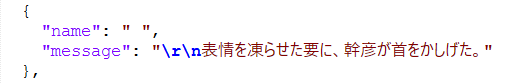 修改后再次用VNTranslationTools将json格式的翻译文本改为spt格式的剧本文件。
汉化4
省略号不正常显示的话,将省略号替换为 ······ 。
制作补丁
分发修改的 spt 等文件, sjis_ext.bin ,可以正常显示文本的 dll 。